NIS 2, Cloud Act, DINUM : on a refondu notre modèle de cahier des charges ...
change de nom...
Les projets autour de l’IA générative démarrent souvent de la même manière : quelques documents, un moteur de recherche, un modèle de langage… et une première démonstration qui fonctionne étonnamment bien. Mais entre un projet expérimental convaincant et un système réellement exploitable en production, il reste beaucoup de chemin.
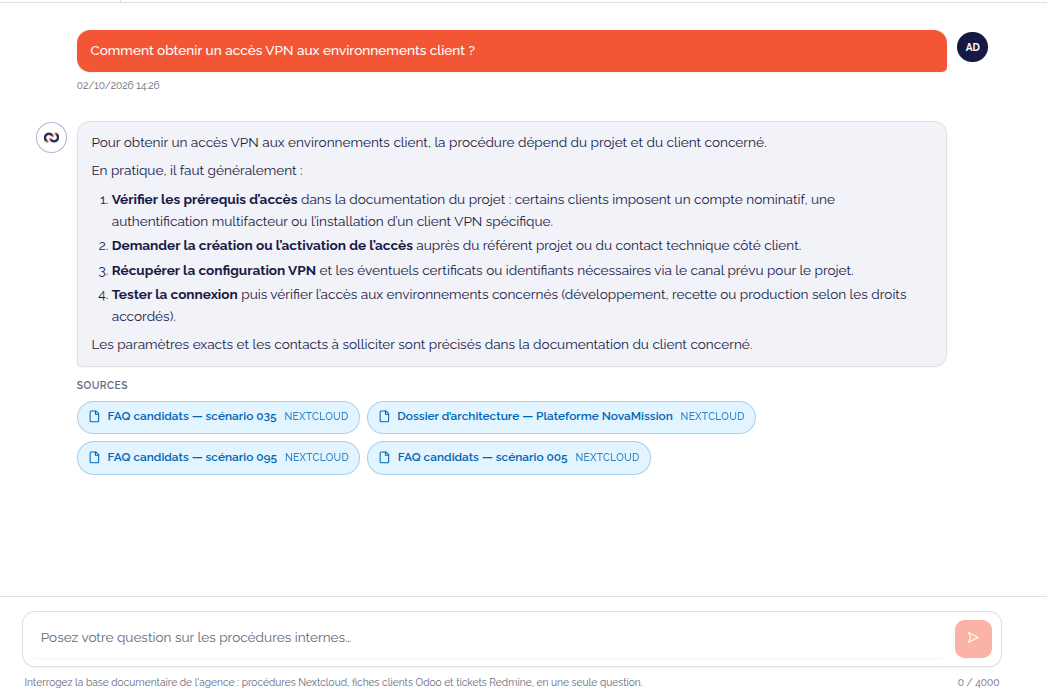
Pour notre premier projet basé sur une architecture RAG, nous avons donc choisi de partir directement de notre environnement Symfony, avec une question en tête : comment construire une brique de recherche assistée par IA qui puisse réellement s’intégrer à nos applications métier, être mesurée, testée et réutilisable ?
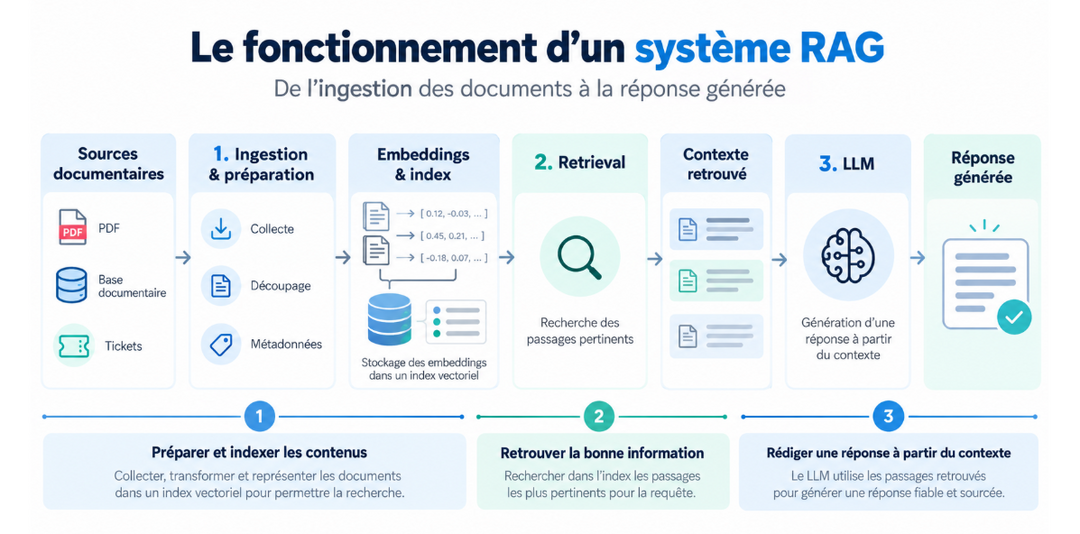
Le RAG, Retrieval-Augmented Generation, ou génération augmentée par recherche documentaire permet à un modèle de langage de construire une réponse à partir d’informations retrouvées dans une base documentaire.
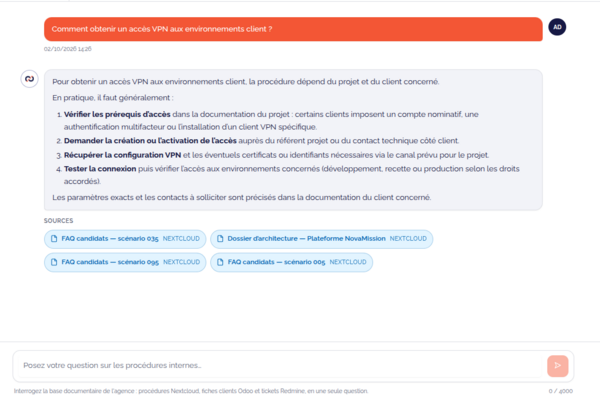
Plutôt que de demander au modèle de répondre uniquement à partir de ce qu’il a appris pendant son entraînement, on lui fournit d’abord les informations les plus pertinentes pour la question posée.
Un système RAG repose ainsi sur trois grandes étapes:
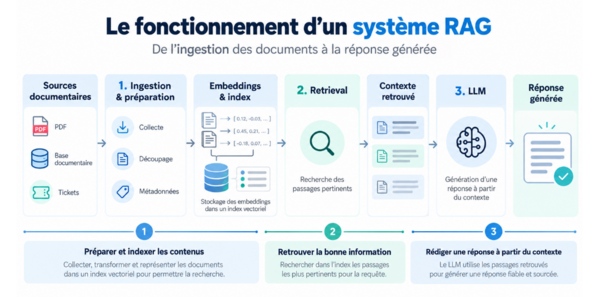
Cette séparation est importante : la qualité de la réponse ne dépend pas uniquement du modèle de langage. Elle dépend d’abord de la qualité des informations qu’on réussit à lui fournir.
Nous avons également choisi de confronter rapidement cette architecture à de véritables données métier, plutôt qu’à un jeu de documents soigneusement préparé pour une démonstration.
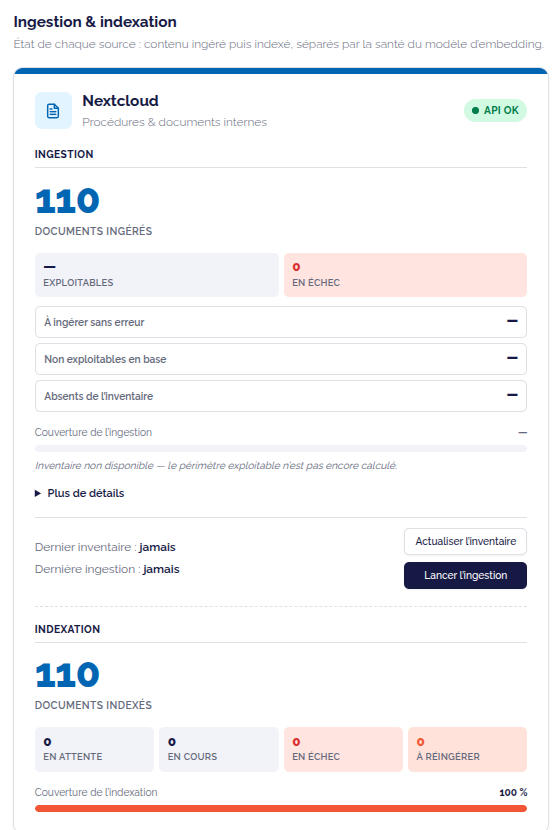
Les documents peuvent être volumineux, hétérogènes, redondants ou structurés de façons très différentes. L’ingestion doit donc gérer leur découpage, leurs métadonnées, leur normalisation, leur indexation et leur mise à jour de manière suffisamment robuste pour pouvoir évoluer avec les sources.
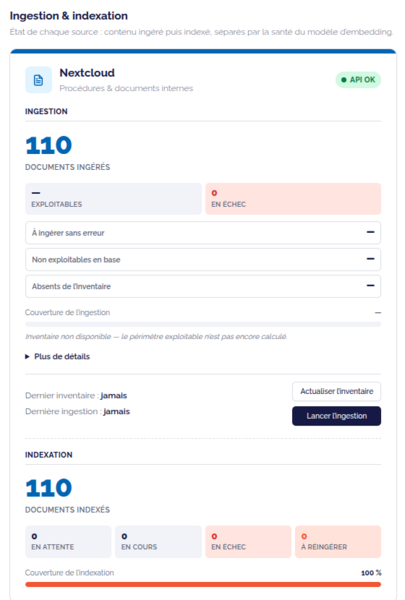
Mais toutes les questions posées à un système RAG ne correspondent pas non plus au même type de recherche. Nous avons donc fait évoluer le moteur pour analyser d’abord la requête et identifier l’intention de l’utilisateur, avant de l’orienter vers la stratégie la plus adaptée.
Pour une question documentaire comme « Quel est le processus d’onboarding d’un nouvel arrivant ? », le moteur s’appuie sur une recherche hybride, combinant recherche sémantique et recherche lexicale. La première rapproche les contenus selon leur sens grâce aux embeddings ; la seconde s’appuie sur les mots et expressions présents dans les documents.
Lorsqu’une référence précise est détectée, par exemple « Donne-moi le ticket #21545 » , une recherche par référence explicite permet au contraire d’accéder directement à l’élément concerné, sans passer par une recherche de similarité.
Certaines demandes relèvent encore d’une autre logique : « Liste-moi toutes les factures de M. Doe en 2026 » ne consiste pas à trouver quelques documents pertinents, mais à interroger un ensemble de données selon des critères précis. Le moteur peut alors router la requête vers une recherche structurée permettant de produire un listing.
Enfin, des demandes comme « Quel est le montant total facturé à M. Doe en 2026 ? » nécessitent non seulement de retrouver les données concernées, mais aussi d’effectuer une agrégation sur celles-ci.
L’objectif n’est donc plus d’appliquer systématiquement le même moteur de recherche à chaque question, mais de choisir le bon mode d’accès à l’information en fonction de l’intention détectée.
Une recherche qui paraît pertinente sur quelques exemples ne suffit pas pour savoir si le système fonctionne réellement.
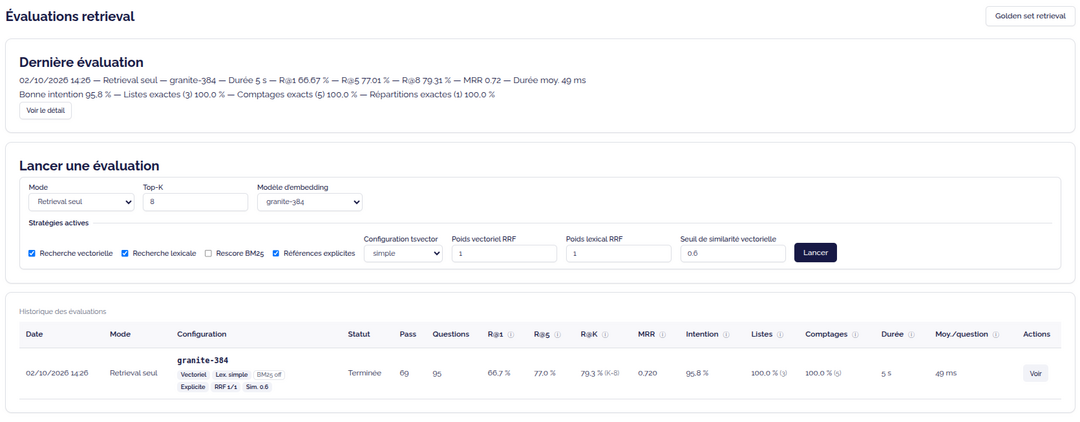
Nous avons donc constitué un jeu de questions de référence, ou golden set, pour lequel les documents attendus sont connus à l’avance.
Chaque évolution peut ainsi être soumise à des tests comparatifs (=benchmark) : le bon document est-il retrouvé, à quelle position, et avec quel temps de réponse ? Cette méthode nous permet de comparer les stratégies de recherche et les modèles utilisés sur des résultats mesurés plutôt que sur une impression générale.
Cette démarche nous permet de comparer différentes stratégies de recherche sur des résultats mesurés plutôt que sur une impression générale, sur notre base de connaissances.
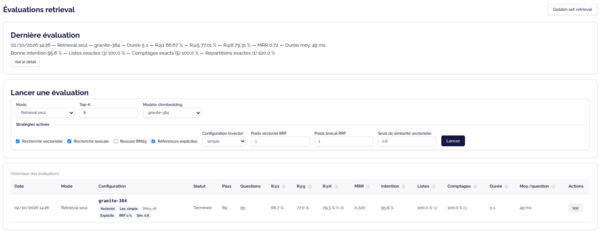
Le choix du modèle d’embedding joue lui aussi un rôle important : il influence directement la qualité de la recherche sémantique, mais également les temps de traitement et les ressources nécessaires.
Nous avons donc comparé plusieurs modèles sur notre jeu de données afin de comparer leur pertinence et leurs performances, sans considérer qu’un modèle plus gros ou plus récent serait automatiquement le meilleur choix. Pour nos besoins, nous avons opté pour un modèle d’IBM : Granite.
Selon les besoins, certaines briques peuvent être exploitées directement dans notre infrastructure, tandis que d’autres peuvent reposer sur des services externes. Dans ce dernier cas, le choix du prestataire et de son hébergement fait partie intégrante de l’architecture : respect du RGPD, maîtrise des flux de données et enjeux de souveraineté doivent rester compatibles avec les valeurs que nous voulons appliquer à nos projets IA chez Codéin. Dans le cadre de notre projet, un modèle Mistral a été retenu comme LLM.
Il ne s’agit donc pas de rechercher systématiquement le modèle le plus puissant, mais de trouver le bon compromis entre qualité, performances, coûts, contraintes d’exploitation et confidentialité des données.
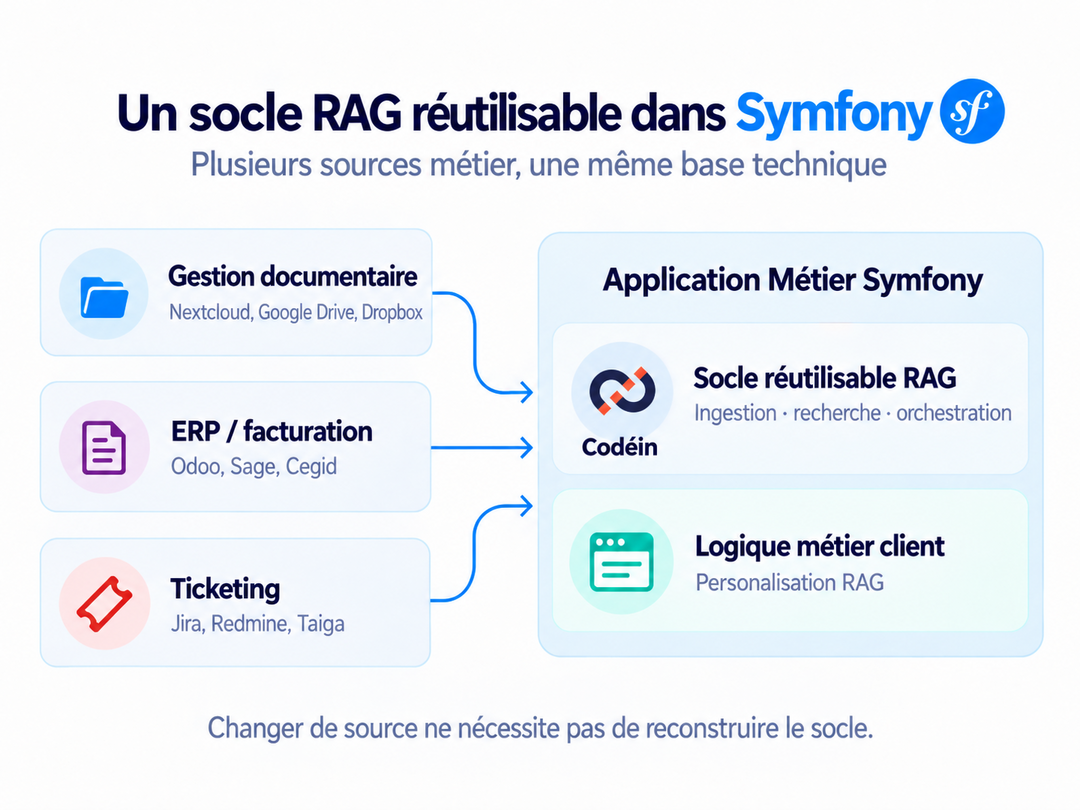
Nous avons fait le choix d’une implémentation sur mesure directement intégrée à notre stack Symfony, plutôt que d’un prototype indépendant reposant sur une infrastructure exclusivement dédiée à l’IA.
L’objectif n’était pas de construire une démonstration isolée, mais une nouvelle brique de notre environnement applicatif, avec les mêmes exigences que le reste : architecture claire, tests, maintenabilité et capacité à faire évoluer les sources de données.
Le socle n’est donc pas lié à une source particulière. Différents connecteurs peuvent alimenter une même chaîne d’ingestion et de recherche : système de ticketing, outil de facturation, gestion documentaire ou autre application métier.
Chaque source peut conserver ses propres caractéristiques grâce aux métadonnées associées aux contenus : type de document, origine, date, client, projet, catégorie métier ou encore droits d’accès. Elles permettent à la fois de conserver le contexte des informations et, lorsque cela est nécessaire, de filtrer ou d’orienter la recherche.
L’idée est ainsi de pouvoir conserver le même moteur tout en adaptant les connecteurs, les métadonnées et les règles de traitement au cas d’usage.
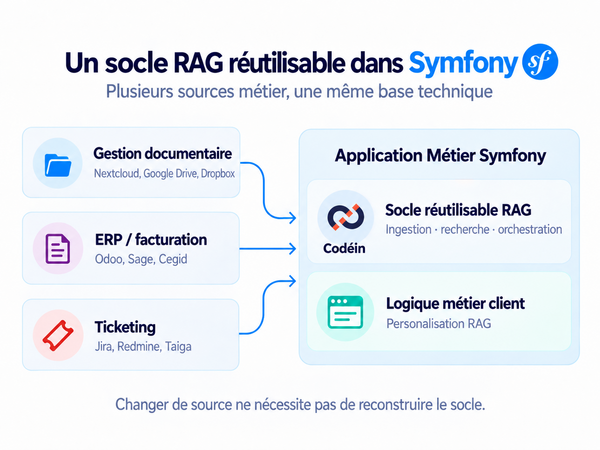
Ce premier socle nous donne surtout un environnement dans lequel nous pouvons expérimenter de manière contrôlée : modifier une stratégie de recherche, tester un autre modèle ou changer une étape de l’ingestion, puis mesurer concrètement les effets obtenus.
Plusieurs sujets plus techniques méritent maintenant d’être approfondis séparément, ils feront l'objet de prochains articles :
Parce qu’en RAG, améliorer la réponse commence souvent par améliorer ce que l’on retrouve.
Quand un modèle souverain n’est pas envisageable, une autre option existe. On peut placer une couche d’anonymisation entre vos équipes et le modèle d’IA, par exemple via une passerelle comme LiteLLM couplée à un filtre de détection des données sensibles. Les noms, e-mails ou numéros de contrat sont masqués avant de partir chez le fournisseur. Pour une partie des usages, cela permet de recourir à un modèle non souverain, à un coût bien plus maîtrisé qu’une infrastructure dédiée.
La limite : l’anonymisation masque des mots, pas un savoir-faire. Si un collaborateur demande à l’IA d’optimiser votre grille de remise ou votre processus de validation des devis, le nom du client disparaît, mais la règle métier, elle, part telle quelle.


 RAG, MCP, hébergement souverain, sans magie, sans promesses floues.
L'IA métier, c'est notre métier.
Notre approche
 L'IA métier, c'est notre métier.
Notre approche
L'IA métier, c'est notre métier.
Notre approche