
Entre un projet expérimental convaincant et un système réellement exploitable ...
change de nom...

Prenons NovaMission, l'entreprise qui nous sert de client de démonstration.
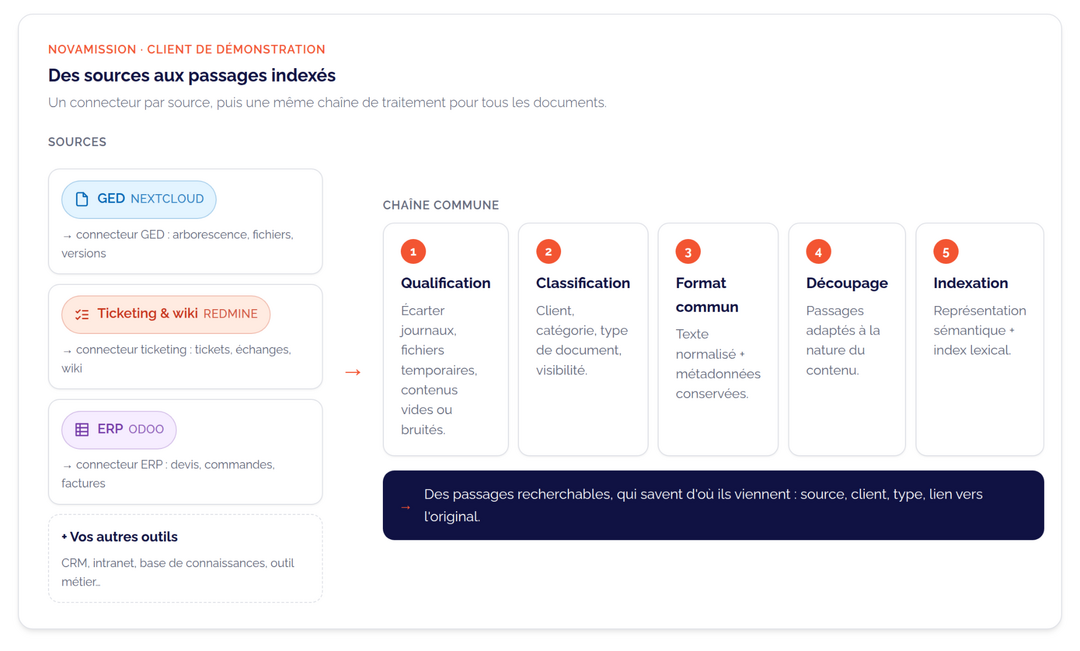
Son information est répartie entre plusieurs outils : une GED pour les documents partagés (procédures, comptes rendus, dossiers d'architecture), un outil de ticketing pour le support et le suivi de projet, un ERP pour les devis, les commandes et la facturation.
Chacun a sa logique, son format et son rythme de mise à jour.
Avant d'ouvrir le moindre document, nous regardons donc la source : comment l'interroger, comment elle est organisée, ce qu'elle dit déjà de ses contenus sans même les ouvrir, et comment détecter ce qui a changé depuis le dernier passage.
Chaque outil est relié au socle par un connecteur indépendant qui porte cette connaissance. Nous en avons déjà développé trois : GED (Nextcloud), ticketing et wiki (Redmine), ERP (Odoo).
Ajouter une source (un CRM, un intranet, une base de connaissances, un outil métier) revient à ajouter un connecteur.
Le moteur d'ingestion, l'indexation et la recherche ne bougent pas. Nous pouvons ainsi enrichir notre catalogue de connecteurs au fil des projets, et chaque client branche les outils qu'il utilise déjà.
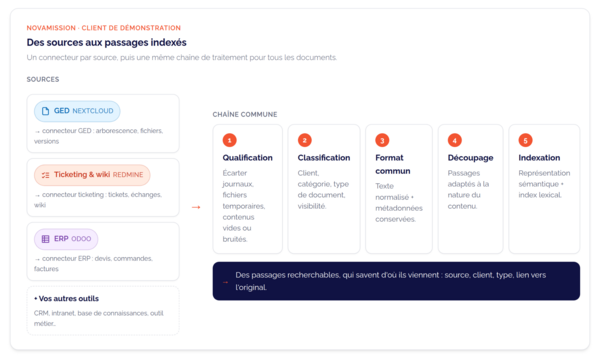
Figure 1 — Chaque source a son connecteur ; les documents passent ensuite par les mêmes étapes de qualification, de classification et d'indexation.
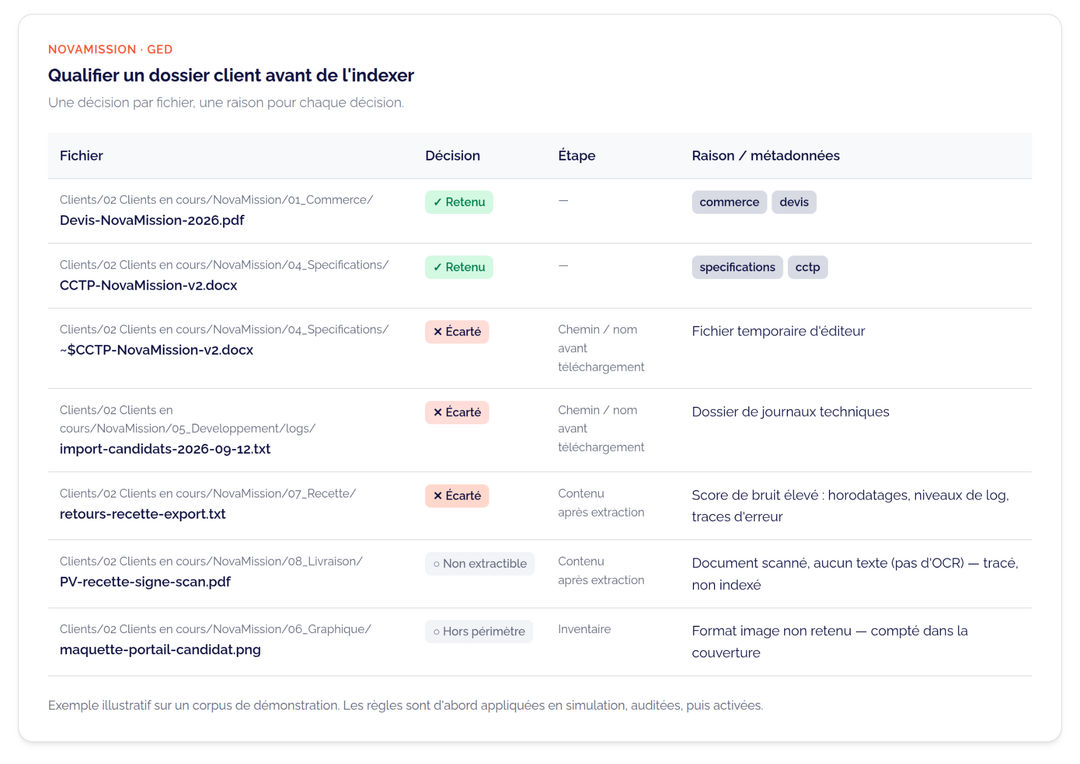
Une fois la source comprise, nous regardons ce qu'elle contient vraiment, document par document. Un jeu de démonstration est préparé à la main, il est propre. Un vrai dossier partagé ne l'est jamais : on y trouve des journaux techniques, fichiers temporaires, exports de débogage, documents scannés, fichiers bureautiques partiellement corrompus, doublons…
Pour la GED, nous qualifions donc les fichiers en deux temps :
Nous avons aussi fait un choix lié à nos besoins : pas d'OCR. Les images et les documents scannés sans texte ne sont donc pas indexés, mais ils sont tracés comme tels plutôt qu'ignorés. Ces règles sont d'abord appliquées en simulation : on mesure ce qu'elles écarteraient, on vérifie, puis on les active.
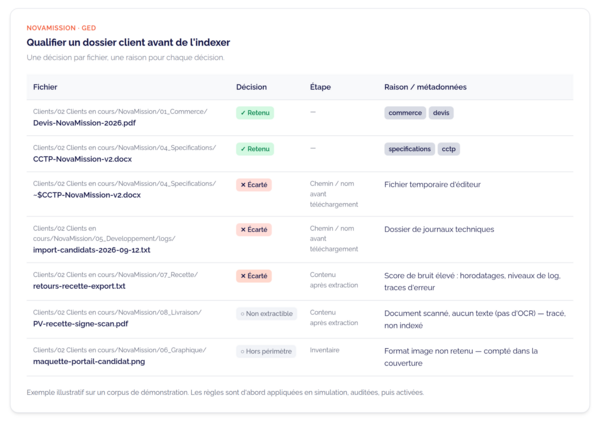
Figure 2 - Qualification d'un dossier client : une décision par fichier, et une raison pour chaque décision.
Cette qualification n'a rien d'un nettoyage ponctuel : elle s'applique à chaque ingestion. Sans elle, la recherche serait noyée sous des contenus qui n'apprennent rien à l'utilisateur.
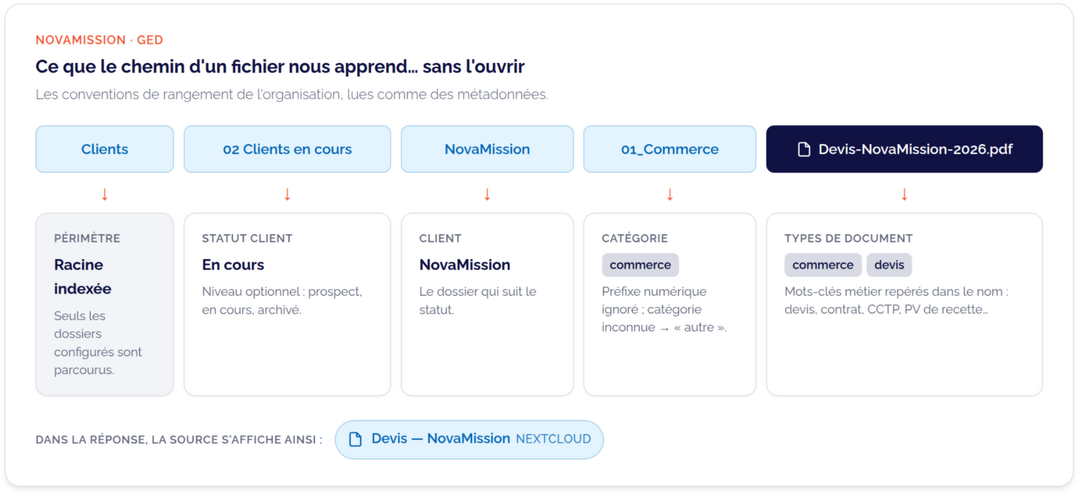
La façon dont une source est rangée est déjà une information. Dans une GED, l'arborescence et les noms de fichiers indiquent à quel client appartient un document, dans quelle phase du projet il s'inscrit, s'il s'agit d'un devis, d'un contrat ou d'un procès-verbal de recette.
Nous exploitons ces indices avant même d'ouvrir le fichier.
Le chemin est découpé et interprété selon les conventions de rangement de l'organisation ; le nom du fichier est comparé à une liste de mots-clés métier. Un document reçoit ainsi un client, un statut, une catégorie et un ou plusieurs types. Si la catégorie est inconnue, le document est classé « autre » et l'ingestion continue.
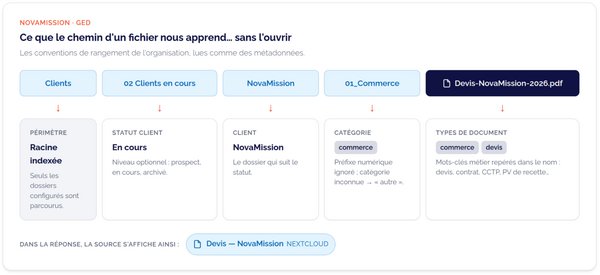
Figure 3 - Le chemin et le nom d'un fichier, lus comme des métadonnées.
Ces règles reprennent les conventions d'une organisation donnée. Chez un autre client, elles seront différentes, et c'est l'un des points que nous adaptons à chaque projet.
Une fois qualifiés, tous les contenus sont convertis dans un format commun. Il permet au découpage et au calcul des représentations de traiter de la même manière un ticket, une facture ou un document bureautique.
Ce format commun garde la trace de l'origine des contenus. Chaque passage conserve ses métadonnées (source, type de document, client, catégorie, dossier, date, lien vers l'élément d'origine, visibilité), et la recherche s'en sert.
Quand on cherche une facture, il faut savoir quels contenus sont des factures. Quand on pose une question sur un client, il faut savoir dans quel dossier client chaque document était rangé.
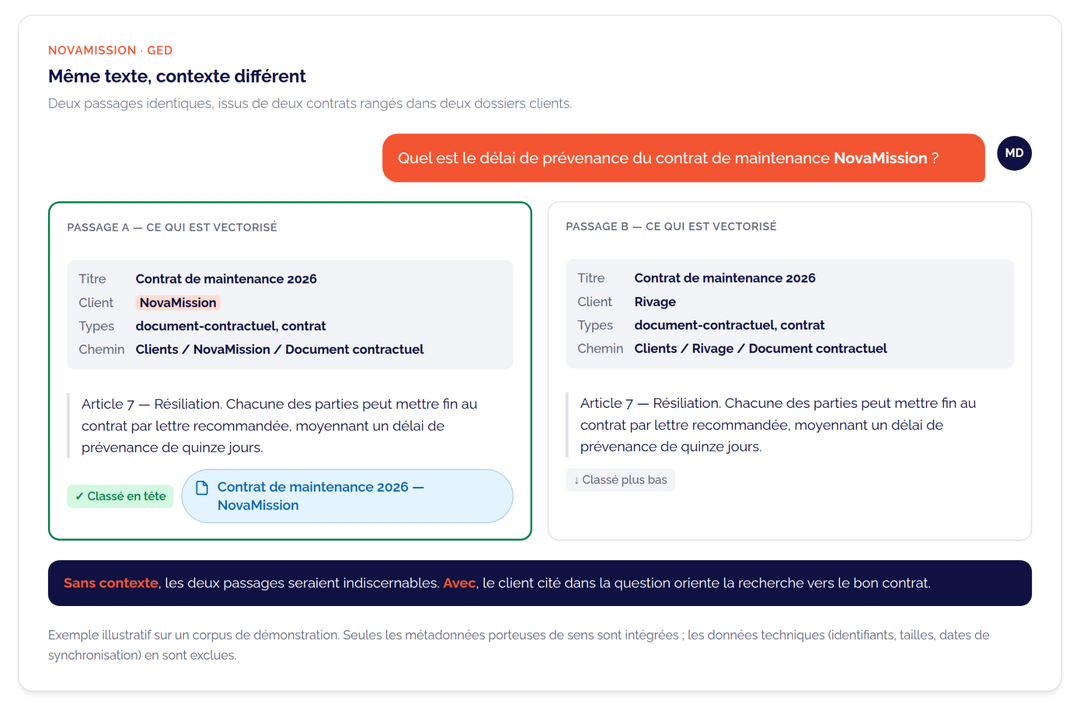
Un passage isolé comme « le délai de prévenance est de quinze jours » est difficile à exploiter si l'on ne sait ni de quel contrat, ni de quel client, ni de quel type de document il provient. C'est pourtant ce que perd un passage une fois extrait de son document.
Pour les sources documentaires, nous intégrons donc à la représentation de chaque passage les éléments de contexte utiles : le titre du document, le client, le type de document, son emplacement dans l'arborescence. Une question qui mentionne un client ou un type de document peut ainsi retrouver les passages correspondants, même si leur texte ne les cite pas.
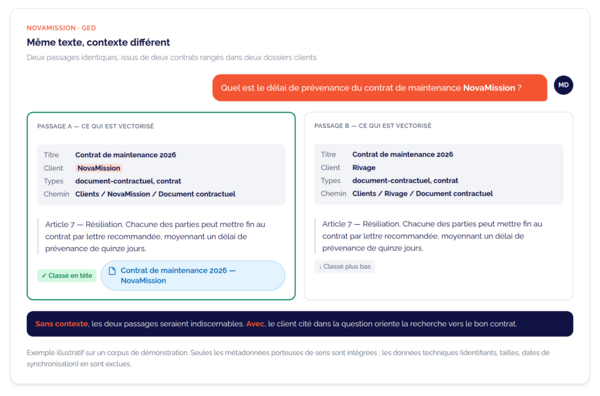
Figure 4 - Même texte, contexte différent : c'est le contexte intégré au passage qui fait la différence.
Les métadonnées purement techniques (identifiants internes, tailles de fichier, dates de synchronisation) sont en revanche exclues de cette représentation. Elles n'apportent rien au sens et fausseraient la comparaison.
Un ticket de support de quelques lignes, un guide de reprise de trente pages et une ligne de facture n'ont rien en commun. Si on les découpe de la même manière, on perd de l'information : un passage trop long dilue le sens, un passage trop court perd son contexte.
Le découpage dépend donc de la nature de chaque source et suit autant que possible la structure des documents : sections, paragraphes, échanges successifs d'un ticket. Il tient compte aussi de la place prise par le contexte ajouté à chaque passage, et des limites du modèle d'embedding : chaque passage est mesuré avant d'être transmis, et ce qui dépasse est traité plutôt que tronqué sans prévenir. Si un document pose problème, l'indexation des autres continue.
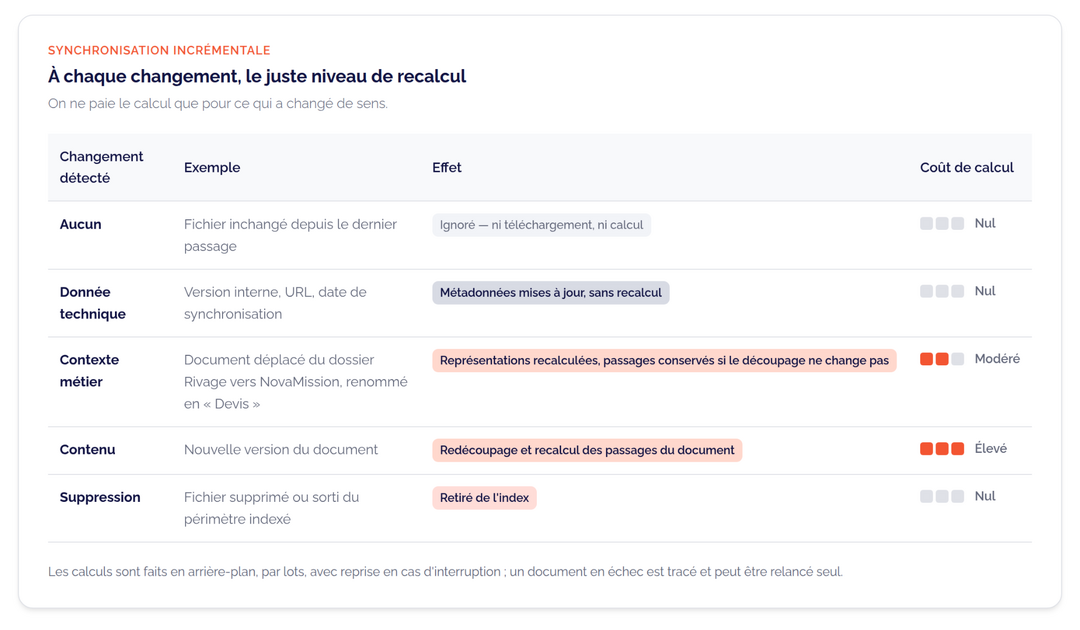
Un RAG d'entreprise s'indexe en continu. Les documents sont modifiés, déplacés, supprimés ; les tickets avancent ; de nouvelles factures sont émises. L'ingestion doit suivre ces évolutions sans tout recalculer à chaque passage.
Chaque connecteur ne récupère que ce qui a changé depuis le dernier passage, et chaque contenu porte une empreinte qui permet de savoir si son sens a réellement évolué. Une simple modification technique est enregistrée sans coût de calcul ; un changement de contenu ou de contexte métier, un document déplacé d'un dossier client à un autre, par exemple, déclenche le recalcul des seuls passages concernés.
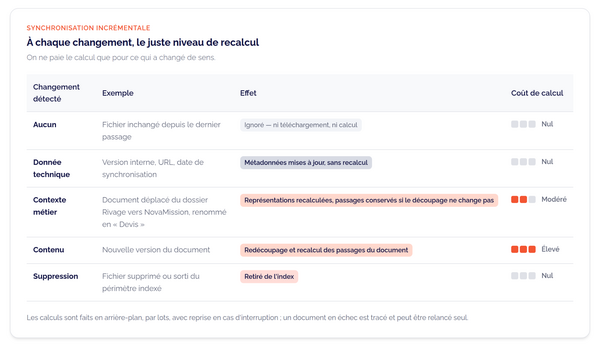
Figure 5 - À chaque type de changement, le juste niveau de recalcul.
Le calcul des embeddings tourne en asynchrone, par lots, avec des points de reprise. Une interruption ne fait pas perdre le travail déjà fait, et un document en échec est identifié, tracé et peut être relancé seul. Un tableau de bord d'administration permet de suivre l'état de l'indexation source par source.
Ces choix ont un effet direct sur les coûts : on ne paie le calcul que pour ce qui a changé.
Tous les collaborateurs n'ont pas accès aux mêmes informations, et un assistant documentaire ne doit pas devenir un moyen de contourner les droits existants.
La visibilité de chaque contenu est donc capturée dès l'ingestion, conservée avec lui, puis appliquée au moment de la recherche : un passage qu'un utilisateur ne doit pas voir n'est jamais proposé, ni à lui, ni au modèle de langage qui construit la réponse.
Face à un nouveau corpus, nous ne reconstruisons pas tout. Nous identifions ce qu'il faut adapter :
Le moteur d'ingestion, l'indexation, la recherche et les outils de mesure restent, eux, identiques.
Une ingestion soignée est nécessaire, mais elle ne suffit pas à garantir une bonne recherche. Reste à savoir si le système retrouve effectivement les bons passages, et à le prouver autrement que sur quelques exemples bien choisis. C'est l'objet du prochain article : golden set, benchmarks et stratégies de recherche.
Une piste que nous avons envisagée, mais écartée de cette première version, consiste à exploiter des modèles d'embedding multimodaux comme EmbeddingGemma 2 de Google. Ce modèle représente textes et images dans un même espace vectoriel : il permettrait d'indexer directement les pages de documents scannés, sans passer systématiquement par une étape d'OCR. Ces documents deviendraient ainsi accessibles à la recherche sémantique, même sans texte extractible. La piste reste à évaluer : retrouver une page pertinente ne suffit pas à en extraire précisément les informations, ce qui nécessiterait ensuite un traitement adapté, notamment par un modèle de langage doté de capacités visuelles.


 RAG, MCP, hébergement souverain, sans magie, sans promesses floues.
L'IA métier, c'est notre métier.
Notre approche
 L'IA métier, c'est notre métier.
Notre approche
Un agent IA souverain pour la recherche documentaire.
Lire le cas Quai des Notaires